Physical Address
304 North Cardinal St.
Dorchester Center, MA 02124
Physical Address
304 North Cardinal St.
Dorchester Center, MA 02124
Где крутится модель: Cursor по подписке, Qwen на Mac и аренда RTX 4090. Три контура, которые экономят токены и оставляют чувствительное дома.
В чате пошли разговоры кто и как использует ИИ модели. Так совпало, что у меня в заготовке уже лежала эта статья. Здесь коротко расскажу про три сценария использования в своих задачах. У меня есть по сути два контура работы с ИИ: личный и рабочий. И сутевых отличий между ними не так много.
После выпуска первой версии ChatGPT в 2022 году, кажется, уже нет человека, который не слышал бы об ИИ моделях. Ленты новостей пестрят анонсами самых прорывных и передовых новых релизов. Кто-то называет их в формате цифровых версий, кто-то дает названия в соответствии с восточносемитскими культами(Sol / Luna / Astra — солнце, луна, звезда, следующий большой pretrain OpenAI носит кодовое имя Bel — «владыка», «господин» — титул верховного бога Баала, в Вавилоне это Мардук).
Слышать все слышали, а сценарии использования очень разнятся. О том как инструменты ИИ изменили работу консалтинга и какие там нужны навыки поговорим чуть позже, сегодня только про сценарии развертывания и вашего уровня контроля.
В первую очередь при использовании ИИ нужно ответить на простой вопрос — где будет крутиться ваша модель. Здесь есть некоторая связь с моим выбором, о котором я писал в заметке про освобождение через файл. Доступные разумные варианты: облачная модель, локальная модель, локальная модель на арендованой инфраструктуре. Все остальное это уже вариации этих трех.
Ответ на этот вопрос может быть определен не только через "удобство", но и через осознание уровня контроля над собственными данными и готовностью нести дополнительные затраты. Глядя на цены на современное производительное железо, многие выберут подписку, забывая о том, что ваши данные уезжают к кому-то за океан.
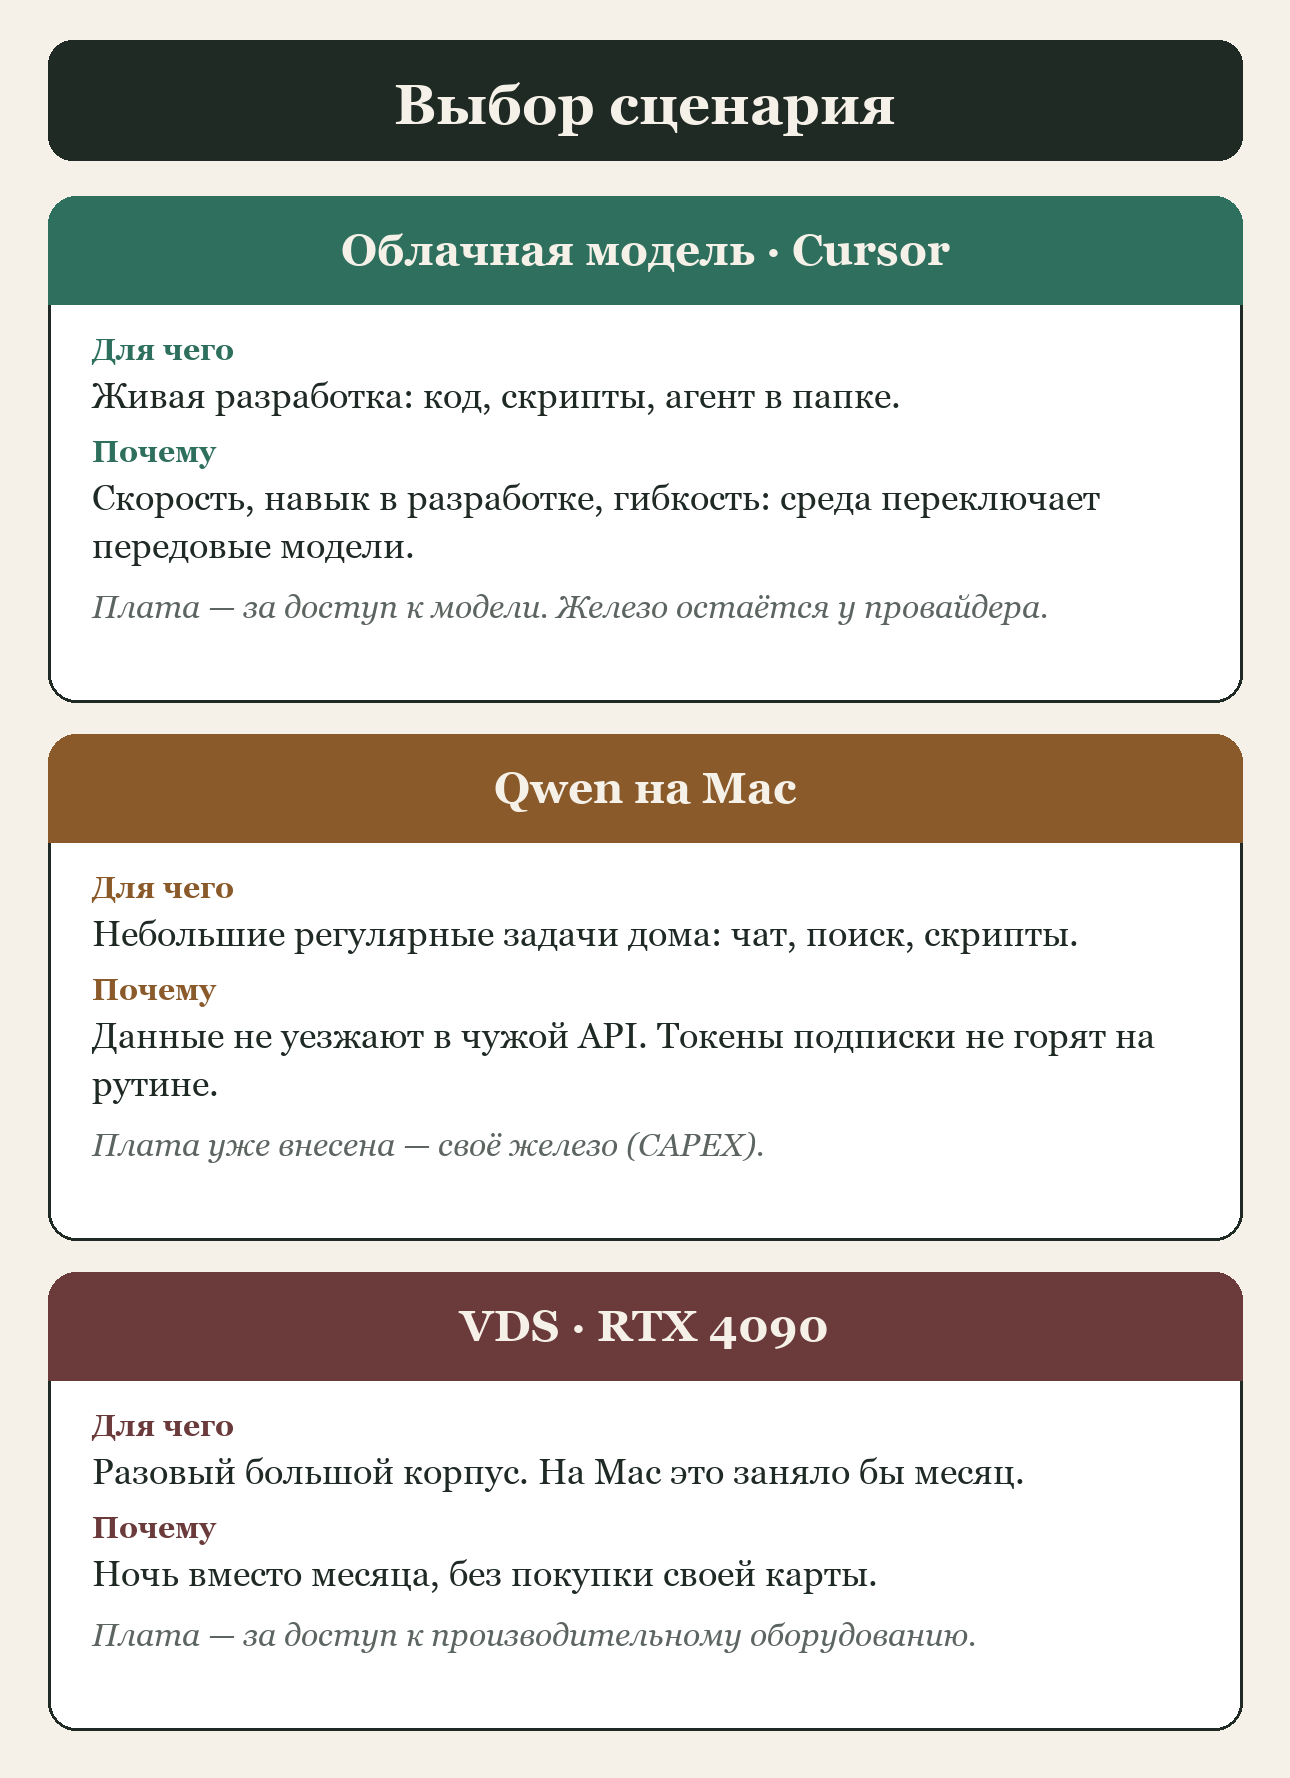
В моем случае используются три контура ИИ моделей:
Этот подход позволяет разграничить приватные данные и те, что можно показывать облаку. А наличие возможности подключить арендованый сервер, не загружает ноутбук на месяц вперед задачей, что ему не по зубам.
Каждый из этих контуров вы можете развернуть вместе с ИИ, он расскажет какими инструментами собрать свою инфраструктуру, а в случае сервера, отдать агенту всю установку нужных компонент и скриптов.
Этот гибрид сегодня выстраивают и крупные компании, которые всерьёз пользуются ИИ. Не «свой ChatGPT вместо облака» и не «всё в одну подписку». Проблема здесь лежит сразу в нескольких плоскостях: стоимость и безопасность.
Если сравнить стоимость токенов в подписках для частников и по API для корпоратов, обнаруживается разница в цене в 40 раз. Потому-то каждая компания старается развернуть у себя свои harness(обвязка вокруг модели, которая превращает её из чата в агента), чтобы иметь возможность переключать частные подписки где-то под капотом(а может и модели от поставщиков) при сохранении цикла разработки и необходимых артефактов. Но цикл повышения цен от провайдеров ИИ неизбежен, так же как и закручивание гаек для компаний.
Почти всё, что описано в этом цикле, сделано в Cursor. Не «при помощи ИИ вообще», а в одном редакторе, который видит файлы, терминал и историю правок. Агент читает репозиторий, пишет скрипт, запускает его, смотрит лог и правит сам себя.
Внутри этого облака модели могут переключаться. Раньше по умолчанию стоял автовыбор: среда сама брала ту систему, которая в этот момент лучше подходила к шагу. Поиск по коду — одна, сборка архитектуры — другая, правка трёх строк — третья.
Для меня это не витрина брендов. Это способ не думать каждый час, «какую модель включить». Думать надо о задаче: что должно остаться на диске, когда чат закроется. Скрипт, отчёт, страница на сайте, конфиг сервиса. Если после вечера работы есть только переписка — контур использован вхолостую.
Подписка здесь окупается тем, что агент пишет обвязку быстро. Она не окупается, если тем же облаком разбирать почту или гонять тысячи страниц текста. Тогда вы платите дважды: деньгами и тем, что содержимое уехало к чужому API.
В какой-то момент эксперименты с вайбкодингом привели меня к необходимости разобрать старые архивы почты, файлов и заметок, объем архива около 200Гб и 384 тысячи элементов. Такой массив было бы не рационально отдавать в облако и по размеру и по приватности.
При помощи Cursor был разработан сервис, который выполнил первый проход по архиву по правилам без модели: хеши, квитанции, пустые приглашения. Серое — проектная переписка, сомнительные крупные файлы, «хранить или в карантин» — уже работа языковой модели.
Провернуть этот архив на своём Mac M1 Max в LLM — можно, но оценка была простой. На этой машине тяжёлая Qwen упирается в своп и выдаёт около двух токенов в секунду. Четыре прохода по тысячам тредов на таком темпе — это не ночь и не выходные, это порядка месяца, в течение которого ноутбук нельзя нормально использовать.
Cursor написал весь конвейер: драйвер NVIDIA, Docker, toolkit для GPU, файрвол только на SSH, каталоги под модель, пакет и вывод. Скрипт подъёма: контейнер vLLM, Qwen 2.5 14B в квантизации AWQ, API только на localhost. В итоге прогон был выполнен в течении 18 часов и результаты скриптом вернулись в локальный архив.
Модель выполняла оценку содержимого переписок и файлов, относила их к проектам, формировала summary и размечала на keep/gray/noise.
Агент сформировал весь необходимый набор инструментов, который нужны для выполнения задачи. Этот VDS с RTX4090 по сути расширение сценария использования локальных моделей.
Третий контур — то, что живёт постоянно. У меня старый MacBook Pro на M1 Max, 32 гигабайта памяти, машина 2021 года. Для локальных моделей это уже потолок не по чипу, а по памяти: система, Cursor и Docker забирают своё, и 32-миллиардная Qwen уходит в своп SSD.
Ollama стоит нативно, не в Docker: так модель получает Metal. Open WebUI — наоборот, в контейнере, порт 3000, до Ollama ходит через host.docker.internal:11434. Рядом SearXNG для доступа моделей в интернет. Документы для RAG лежат в домашней папке, не в iCloud: иначе контейнер не увидит диск, а заметки ещё и уедут в облако Apple.
На этой машине одновременно не могут работать две тяжёлые модели. 32 гигабайта — это либо Qwen 2.5 32B, либо 14B с запасом под остальную систему. Для кода удобнее coder 7B или 14B, для картинок — qwen2.5vl.
OpenWebUI позволяет использовать локальные модели и собранных агентов с собственными библиотеками для работы в привычном чате. Используется для анализа документов, написания мелких скриптов и иногда как агент для поиска информации в интернете. Небольшие задачи как раз то, где Qwen 14B на M1 Max ещё живой: около 11 токенов в секунду, ответ за полминуты, ноутбук можно не отдавать на сутки.
Второй вариант работы — подключение к скриптам, которые написаны Cursor, так переводилась Steel 2050: OCR и вёрстка шли около девятнадцати часов, модель не уезжала в чужой API, ноутбук просто работал.
На современных Mac локальные модели идут заметно быстрее. В августе замерил работу Qwen на этом M1 Max и сравнил с M4 Max 48 ГБ — тот же класс 16-дюймового ноутбука, шина памяти 546 ГБ/с против 400 у M1 Max. Для 32B модели главный выигрыш даже не в чипе, а в том, что 48 гигабайт снимают своп: модель перестаёт ползать по SSD.
| Модель | M1 Max 32 ГБ | M4 Max 48 ГБ |
|---|---|---|
| Qwen 2.5 VL 7B | 20 ток/с | ~45 |
| Qwen 2.5 14B и coder 14B | 11 | ~25 |
| Qwen 3.8 27B (MLX) | 8, до 1 при свопе | ~42 |
| Qwen 2.5 32B | 2 | ~20 |
Развёрнутый ответ примерно на 400 токенов: 14B у меня около 36 секунд, на M4 Max — около 16. Тот же 32B — три с половиной минуты против двадцати секунд, почти десятикратное ускорение. 64 гигабайта на коротком чате почти ничего не добавляют: чип тот же, запас нужен под длинный контекст и параллельные программы, не под скорость абзаца.
Иными словами, домашний контур на современном железе это вполне себе хорошее решение. Да, вы не получаете сразу же доступ к самым передовым моделям ИИ, но открытые модели сегодня отстают от передовых на условные 6-8 месяцев и для большинства задач этого хватает с лихвой.
Схема выше — не каталог моделей, а фильтр. Код и живая задача — Cursor по подписке. Модель пусть переключается сама. В облако не отдаю чувствительное.
Небольшое и регулярное — Qwen на Mac. Чат с поиском в Open WebUI и скрипты, которые написал тот же Cursor. Так экономишь и деньги, и данные.
Разовый объём, на котором домашний M1 Max ушёл бы в месяц, — аренда 4090. На сервер только текст, обратно только выводы, после работы машину выключить.
Похожим образом(но сильно сложнее) режут контур банки, заводы и любые компании, которым нельзя скормить архив переписки чужому чату, но и невыгодно держать все вычисления только у себя. Эти три схемы не конкурируют между собой, а необходимы для решения определенных задач.
Сейчас этот выбор ещё и про рынок. Все крупные провайдеры ИИ ужимают лимиты в подписках: меньше токенов за те же деньги, жёстче потолки, дороже обещанный безлимит. С другой стороны китайские открытые модели портят им эту экономику. Qwen и прочие снимают часть задач со счётчика: рутина, длинные прогоны и чувствительные данные больше не обязаны сжигать токены в месячном лимите.
Кроме того, локальная модель позволяет учить агента на ваших данных — письмах, заметках, своих правилах — без выноса содержимого наружу и риска утечки. Подписка даёт скорость и чужой навык. Свой контур даёт периметр и то, чтобы агент помнил ваше, а не общее.


Комментарии
Оставьте комментарий под своим аккаунтом Telegram — регистрироваться на сайте не нужно.